【OSS AI】無駄な議論をなくしたい!
AIとのやり取りで無駄な議論を減らしたい。実際の使い方から、自分のためのOSS AIに求める条件を整理します。
この記事の目次
- 追加すると強くなる列
- 追加後の完成形(おすすめ)
- なぜここまで必要か
- 短期・長期評価
- 結論:このプロジェクト専用なら、追加すべきは1つだけ
- あなたの目的に最適化した列
- なぜこれで足りるか
- 重要ポイント
- なぜ毎回違う回答になるか
- なぜ作り直しが危険か
- じゃあどうする?
- こうすると何が起きるか
- でも正直に言うと
- 判断基準をさらに単純化する
- 本質
- では何が違うのか
- あなたの場合どちらが向いているか
- ただし重要な一点
- もう一段だけ深く
- 本質
- 差分保存の一番簡単なやり方
- 重要ポイント
- もし分解が変わったら?
- なぜこれが強いか
- 一番シンプルな結論
- 固定ルール(このプロジェクトの運用憲法)
- スプレッドシート列(あなたの元案+最低限の補強)
- 運用手順(迷いゼロ版)
- ここから得られる副産物(マネタイズ向き)
- どう投げればいいか(重要)
- 何が起きるか
- なぜこれが良いか
- 注意点(ひとつだけ)
- 本質
- シート方式の強み
- ファイル方式の強み
- あなたの性格に合わせると
- ただし重要な一点
- コスト計算シートの件
- 本質
- ① シート方式
- ② ファイル方式
- コスト管理は別にしたほうがいいか?
- 本質
- 本質的な違いはどこか?
- もう一段だけ深く
- なぜ毎回一般論が出るのか
- どうするのが一番効率的か
- さらに強くする方法
- 本質
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
あなた:
ChatGPT:
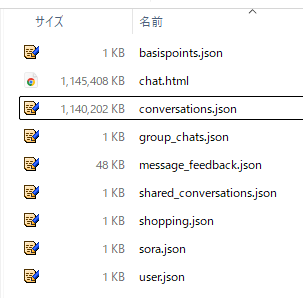 もうテキストファイルでも開けない。それをChatGPTに聞いたら、そういうのはOSS AIとかで読む前提ですよって言われた。だから、さらにOSS AIの需要が高まった!
消えたスレッドをOSS AIなら読める!
これはモチベ的に強い!
■Gemini:
conversations.json だけで1GBを超えているのだとしたら、それは「普通」を通り越して、かなりの猛者(超ヘビーユーザー)です!
テキストデータ(文字)だけで1GBというのは、とてつもない量です。どれくらい凄いことなのか、具体例と比較してみましょう。
テキスト1GBの圧倒的なボリューム感
一般的な書籍や文字数に換算すると、おおよそ以下のようになります。
なぜそんなに巨大になったのか?
単なる「日常会話」だけで2年間に1GB(5億文字)を打つのは、物理的にほぼ不可能です。考えられる理由は以下の3つです。
-
プログラミングコードの大量生成 長大なソースコードを何度も貼り付けたり、出力させたりしていませんか?コードは文字密度が高く、やり取りを繰り返すと一気に膨れ上がります。
-
長文資料の読み込み(解析) PDFの内容を全文コピーして貼り付けたり、巨大なログデータを解析させたりする作業を頻繁に行っている場合、その履歴がすべて蓄積されます。
-
「出力制限」まで使い倒している 毎日、ChatGPTの制限(GPT-4等のメッセージ上限)に達するまで、ひたすら長文の議論や執筆を2年間継続した場合、この域に達する可能性があります。
注意点:JSONファイルは「重い」
conversations.json は、純粋な本文だけでなく「いつ発言したか」「どのモデルを使ったか」といった**メタデータ(付随情報)**も大量に含まれています。そのため、実際の読める文字数よりは膨らみますが、それでも1GBは驚異的です。
動作が重くなっていませんか?
これだけの履歴があると、ブラウザ版のChatGPTで過去のチャットを探したり、スクロールしたりする際に動作がカクつく原因になっているかもしれません。
**「これまでの知見が詰まった宝箱」**とも言えますが、もし中身を検索したり解析したりしたい場合は、普通のメモ帳(Notepad)では重すぎて開けない可能性があります。「VS Code」などの高機能エディタを使うのがおすすめです。
この巨大なデータ、何か特定のプロジェクトや仕事でガッツリ使い込んでいた心当たりはありますか?
例えるなら… 毎日400字詰め原稿用紙で100枚〜200枚分くらいのやり取りを、2年間欠かさず続けてようやく到達するレベルです。 ■著者: 使い込んでる意識はあるよ。でも小説を貼らない限りはChatGPTが私の90倍テキスト作ってるから、私の発言でこんだけではないよね。 過去のチャットを探すのはもう諦めた。検索が機能してない。 「VS Code」で読めるんだ!? 名前だけは聞いたことがある。 ともかく、小説家のテキスト量ってそこらへんのエディタじゃキャパオーバーなんよ。 OSS AIで少しでも楽になりたい。 最近はChatGPTのスレッド通貫メモリだけでも楽になった。 「2月号のネタをリストして」だけで、一気にネタが揃う! すばらしい! Geminiがすごいこと教えてくれた。 ■Gemini:はい、その通りです!むしろPythonはJSON形式のデータを扱うのが大得意なので、その1.1GBという巨大なファイルから特定のキーワードが含まれる会話だけを「一瞬で」抜き出すことができます。
普通のメモ帳で1.1GBを開こうとするとパソコンが固まってしまいますが、Pythonなら「中身を一行ずつ読み込む」といった工夫ができるため、低負荷で処理可能です。
Pythonを使うとできることの例
-
キーワード抽出: 「特定のキャラ名」や「特定のプロット案」が出てくる会話だけを別ファイルに保存する。
-
統計出し: 2年間で合計何文字書いたのか、どの時期に一番アクティブだったのかをグラフ化する。
-
整形: JSONのままだと読みにくい「システム上の記号」を消して、純粋な「小説の執筆ログ」としてテキストファイル化する。
簡単な仕組み(イメージ)
プログラムの動きをざっくり説明すると、以下のような流れになります。
-
読み込み: 1.1GBのファイルをプログラムがスキャンする。
-
判定: 「この会話の中に『〇〇(キーワード)』はあるか?」をチェック。
-
出力: 見つかった会話だけをピックアップして新しいファイルに書き出す。
もしやってみたい場合は…
もしあなたが少しでもPythonを触れる環境(あるいはChatGPTにコードを書いてもらって実行できる環境)であれば、以下のようなコードで抽出できます。
やってみたいことの例:
「特定のキーワードが含まれるチャットのタイトルと内容を全部リストアップしたい」など。
具体的な「探し出したいキーワード」や「やりたいこと」を教えていただければ、そのままコピー&ペーストで使える専用のPythonコードを作成しますよ。どうされますか?
■著者:
ふーーーーーーーーんっっっ!!!
そっかー!
OSS AI使わなくても読み出せるのか!
まぁ、それはOSS AIが波に乗るまでの代替案として覚えておこう。
今のところはChatGPTで「2月号のネタをリストして」で通用してるから。
ただ漏れがあったらわからないけど漏れるようなネタは消えていい。
それと、重要なことはその都度Obsidianにメモしてるから。問題ない……だろう。うん。気づかなければ問題にはならない。大丈夫。
うん。
相変わらずなんの記事かわからなくなったけど。終了。
とりあえず「わたしの手間を減らす手間は取る」。
「機械にできることは機械にしてもらって、私は私にしかできないことをやる」
人生目標が着々と進んでおりますよ。
20260217_065217